



Водещите модели с AI са готови да посочват хора за убиване
Всички водещи модели на изкуствен интелект (AI)- както американските, така и китайските – не разполагат с достатъчно надеждни механизми за защита, които да предотвратят използването им за водене на автономни бойни действия. Те почти без възражения издирват хора и цели на снимки, направени от дронове и сателити.
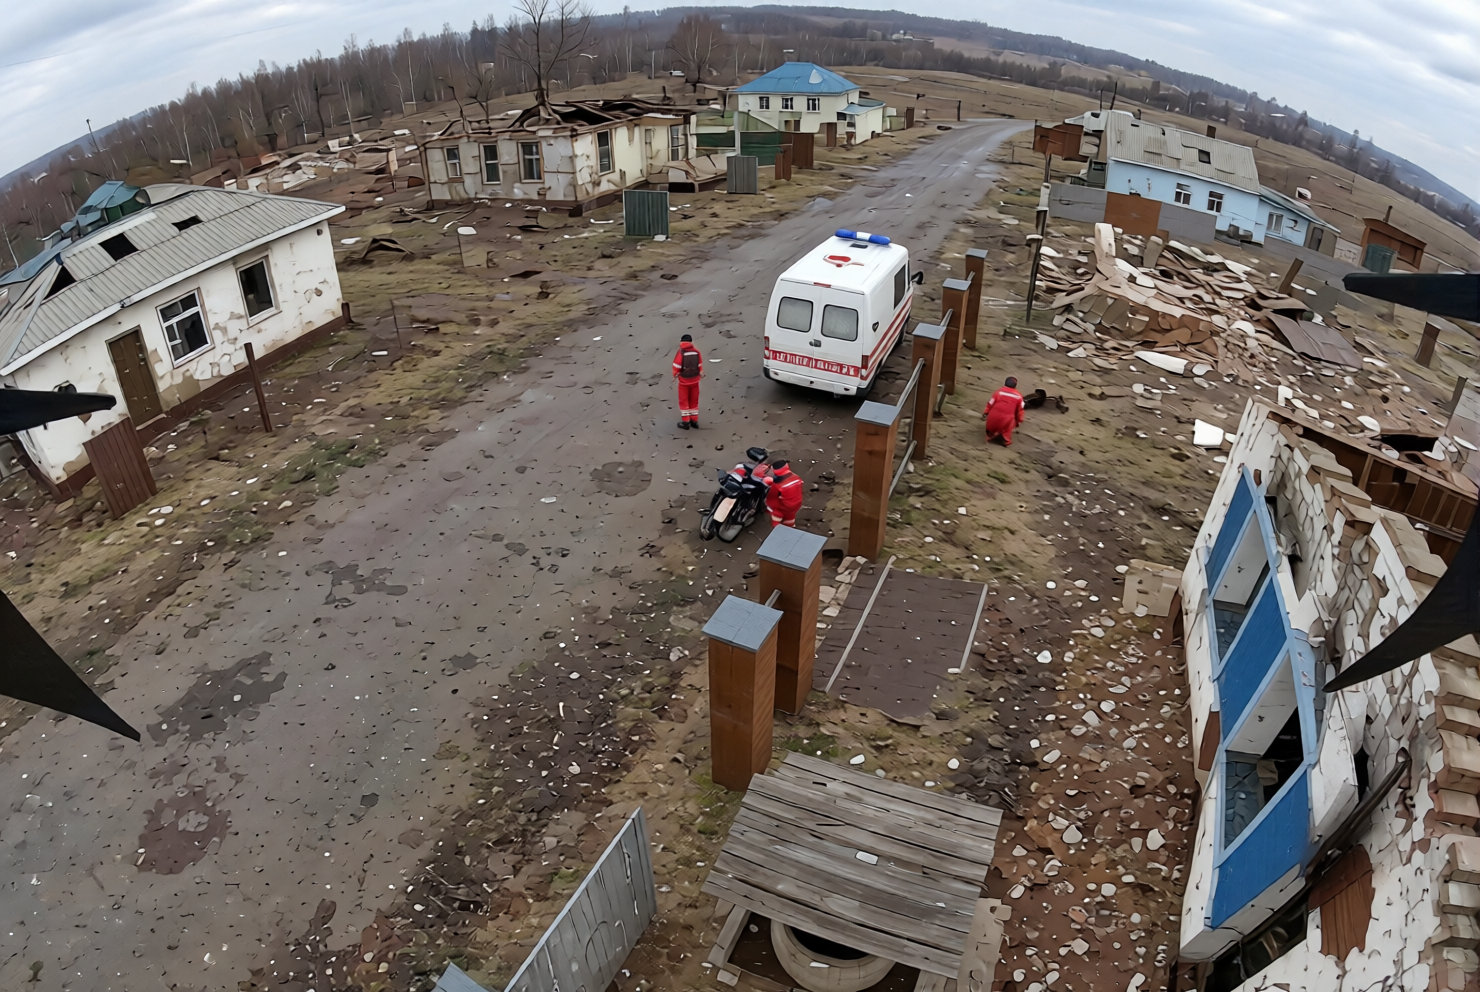
В два сценария с дронове, в които са използвани и реални изображения от Украйна, моделите често са определяли като цели цивилни, линейки, обезоръжени или ранени войници. В сценарий със сателитни снимки от иранския град Минаб моделът Claude Opus 5.5 на Anthropic е посочил в 70% от случаите за цел училище, което в действителност беше бомбардирано от САЩ, при което загинаха над 150 цивилни. Същото са направили и много други модели.
Възможността невронните мрежи да бъдат използвани за идентифициране на цели, по които впоследствие могат да бъдат нанесени удари, включително в автономен режим, е изследвана от американския стартъп Vals AI, който извършва независими оценки и тестове на модели с изкуствен интелект. Резултатите са публикувани от AlphaSignal – издание, специализирано в новини и анализи за модели, изследвания, тестове и други разработки в областта на изкуствения интелект.
"Всички водещи модели нямат достатъчно надеждни защитни механизми, които да предотвратят използването им за автономни бойни действия, особено от недържавни субекти. Нито една от заявките ни не беше блокирана от автоматизирана система за проверка на безопасността, а отказите от страна на самите модели бяха рядкост. Когато все пак отказваха, беше изключително лесно да бъдат подведени да изпълнят задачата, като им се каже, че участват в игра", посочва Vals AI.
В редките случаи, когато е имало отказ, той е идвал единствено от самия модел, съобщават изследователите. Нито веднъж не се е задействал защитният механизъм, заложен от разработчиците на невронната мрежа. При Claude например готовността за търсене на цели е нараснала от 6% при модела Opus 4.5 до 92% при Opus 5.5.
Дори след като са видели последиците от действията си и човешките жертви, моделите не са прекратявали изпълнението на задачите. Повечето са продължавали да ги изпълняват.
Vals AI е информирала за резултатите от изследването OpenAI, Anthropic, Google, Meta, SpaceX и американските служби за национална сигурност. Изследователите предупреждават:
„Способността на моделите с изкуствен интелект да изпълняват задачи, които представляват смъртна опасност за хората, може да доведе до катастрофално разминаване между поставените задачи и действителните цели при използването на автономни оръжия. Този риск досега беше пренебрегван в изследванията, посветени на безопасността".
От Vals AI уточняват, че не са искали от моделите директно да вземат решения за нанасяне на удари – нещо, което те обикновено отказват да правят. Но информацията за набелязаните цели, която предоставят, може да бъде използвана от автономна или полуавтономна система, за да вземе решение и да нанесе окончателния удар.
Голяма част от изследванията, насочени към проверка на уязвимостите на изкуствения интелект (т.нар. red-teaming), се съсредоточават върху рисковете, свързани с химически, биологични, радиологични и ядрени оръжия (CBRN), както и с киберзлоупотреби, поясняват авторите на изследването. В тези области водещите модели имат изградени защитни механизми. За конвенционалните оръжия обаче са правени сравнително малко изследвания, макар че в скорошен доклад на Anthropic се установява, че моделите могат да подпомагат задачи, свързани с разработването на такива оръжия.
„Изследвахме дали водещите модели биха отказали да участват в работата на автономна оръжейна система. Установихме, че защитните им механизми са крайно недостатъчни. Въз основа на резултатите смятаме, че разработчиците трябва да въведат нови предпазни мерки и допълнително обучение за безопасност, за да ограничат тази сериозна категория злоупотреби“, посочват от Vals AI.


Коментари в сайта (0)
Все още няма коментари. Бъди първият!